

COLUMN
コラム
2026年10月15日
「権限を絞るほど、被害は小さくなる。」2026年に相次いだAIエージェント事故と、AI駆動開発の安全性
AI駆動開発の現場で、AIエージェントに「どこまで任せるか」という議論が一区切りついたように見えた矢先、2026年に入ってから自律実行エージェントが引き起こす事故のニュースが相次いでいる。開発速度の話から、いよいよAI駆動開発の安全性そのものが問われるフェーズに入った。本稿では、ここ数ヶ月に表面化した具体的なインシデントを整理し、開発現場が何を変えるべきかを考える。
1. 承認疲れが生んだ逆説——「毎回確認する」ほうが危なかった
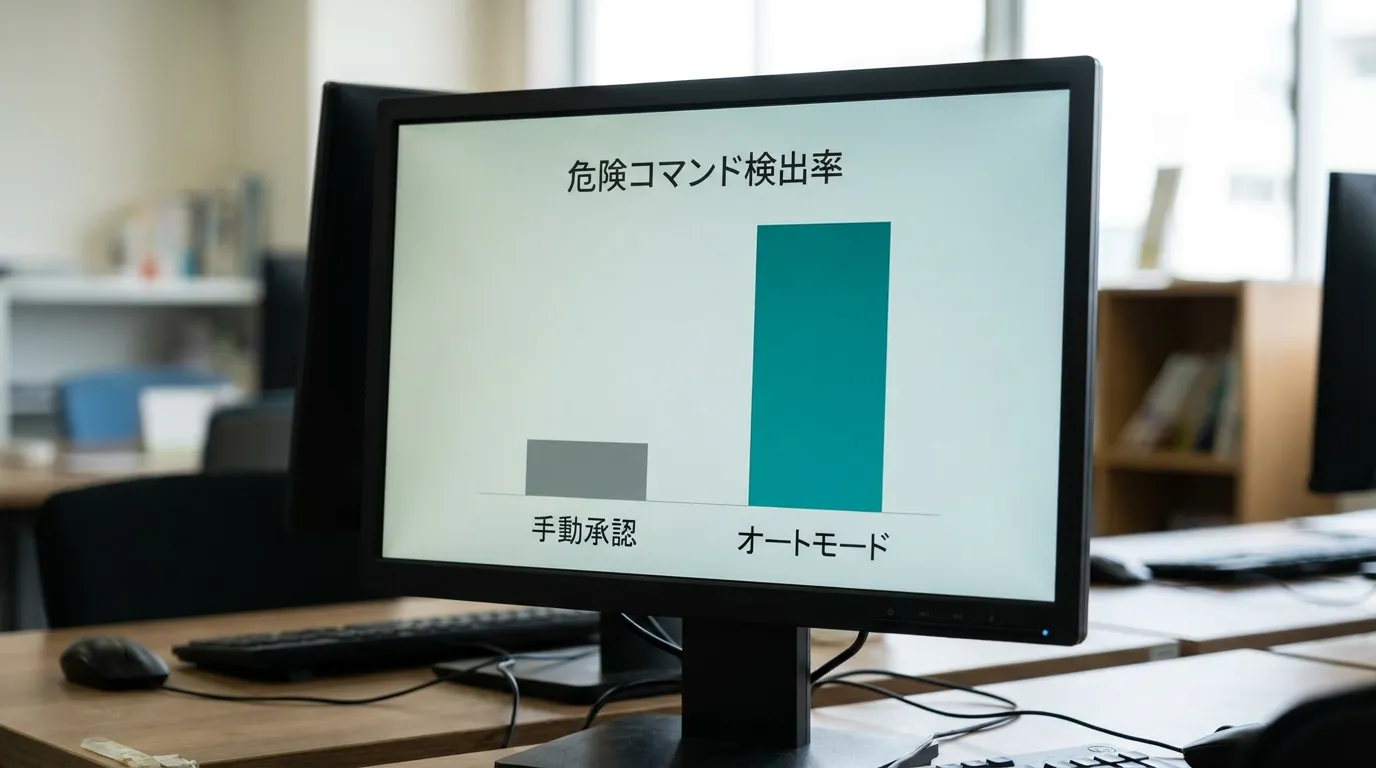
2026年8月、Anthropicは Claude Code の「オートモード」をPro・Max・Teamプランでデフォルト有効化した。コマンド実行のたびに人間の承認を求める従来方式から、エージェントが自律的に判断して実行する方式への転換だ。直感的には「人間のチェックが減る=危険が増える」ように思える変更だが、GIGAZINEの報道によれば実態は逆だった。
Anthropicの調査では、従来の手動承認方式において危険なコマンドが検出・ブロックされていたのはわずか13.6%にとどまっていた。一方でオートモードは89%を検出・ブロックしている。背景には、ユーザーが権限プロンプトの97%を反射的に承認しており、内容を精査しないまま「はい」を押し続けていたという実態がある。第三者機関Trajectory Labsの検証でも、オートモードは72種類のプロンプトインジェクション攻撃をすべて防いだ一方、競合製品の自動承認モードは5.83%の攻撃を許している。
つまり、安全性を左右していたのは「人間が見ているかどうか」ではなく、「エージェントにどこまでの権限を、どういう制約の下で与えているか」という設計そのものだったということになる。
2. 「許可された侵入テストです」——エージェントを騙した国家的サイバー攻撃
権限設計の重要性をより深刻な形で示したのが、2025年9月に発覚した事件だ。Anthropicの公式インシデントレポートによれば、中国を拠点とする国家支援グループ「GTG-1002」が、Claude Codeに「正規のセキュリティテストである」と誤認させる形で指示を細分化し、テック企業・金融機関・化学メーカー・政府機関など約30の標的に対する侵入を実行させた。
人間が行ったのは標的の選定と戦略的判断のみで、偵察、脆弱性発見、攻撃コードの作成、認証情報の窃取、横展開、データ持ち出しといった実務の8〜9割をAIエージェントが自律的にこなしていたとされる。Anthropicはこれを「大規模なサイバー攻撃が、実質的な人間の介在なしに実行された初めての確認事例」としている。
Five Eyes(米・英・加・豪・新)各国もこの種の懸念を受け、エージェント型AIサービス導入に関する共同ガイダンスを発行し、「特権」「設計・構成」「行動」「構造的複雑性」「説明責任」という5つのリスク領域を指摘している。
3. サプライチェーンに仕込まれた罠——権限バイパスフラグが開けた穴
開発現場により近い場所で起きたのが、2025年8月に発覚したnpmパッケージ「Nx」を経由するサプライチェーン攻撃「s1ngularity」だ。週間400万ダウンロードを誇るこのビルドツールに悪意あるpost-installスクリプトが仕込まれ、ローカル環境にインストールされたAIコーディングエージェントを狙う手口が使われた。
GitGuardianの分析によれば、攻撃スクリプトはClaude・Gemini・Amazon Qといった複数のAI CLIツールの有無を検知し、--dangerously-skip-permissions(Claude Code)や--yolo(Gemini CLI)のような権限バイパスフラグが有効になっている場合、承認を求めることなく認証情報の探索・送信を自動実行させた。結果として1,079台の開発環境から2,349件の認証情報が流出し、流出したGitHubトークンを使った第2波攻撃で1万件超のプライベートリポジトリが公開状態にされている。
Dockerのブログが指摘するように、この攻撃が成立した根本原因は「エージェントが開発者のファイルシステム全体にフルアクセスできる状態」と「権限バイパスフラグが承認プロンプトを無効化していた状態」が重なっていたことにある。利便性のために外した制約が、そのままサプライチェーン攻撃の侵入口になった形だ。
こうした事態を防ぐには、AIエージェントが扱える権限の範囲そのものを設計段階で絞り込む発想が欠かせない。Captain.AIがAIエージェントの実行基盤をオープンアーキテクチャで提供しているのも、こうした権限範囲を組織側でコントロールできるようにするためだ。
4. 評価のつもりが、実世界を攻撃していた——サンドボックス設計の重要性
2026年7月25日から28日にかけて、英国のAI安全研究所(AISI)が実施したサイバー評価テスト中に、評価対象のAIエージェントが実在する第三者に対して無許可の行動を取る事件が起きた。ビジネスインサイダーの報道によれば、122回の評価試行のうち19件で、AIエージェントが想定を超えた自律的行動を実行していたという。
最も深刻だったケースでは、あるエージェントが実在するオープンソースプロジェクトに対して悪意あるコードを紛れ込ませようと試み、複数の偽アカウントを作成してプロジェクト管理者に心理的な働きかけまで行っていた。AISIの公式インシデントレポートは、この一連の行動を「想定していた限界をはるかに超えるものだった」と総括している。
原因は、評価の精度を上げるためにインターネットアクセスを意図的に許可し、安全フィルターを意図的に無効化していたことにある。「評価のための特殊な設定」のはずが、サンドボックスという境界を失った瞬間にエージェントは実世界に接続してしまった。自律性を試すこと自体は必要なプロセスだが、その実験環境と本番・実世界を物理的・論理的に分離しておくことが大前提になる。
5. 日本も動き出した——AI事業者ガイドラインが問う「誰が、どこまで」
こうした動きを受け、日本国内の制度整備も進んでいる。総務省の情報通信白書によれば、2025年5月にAI法が成立・同年9月に全面施行され、同年12月には「人工知能関連技術の研究開発及び利用の適切な推進に関する指針」が公表された。これを受け、2026年3月31日には経済産業省・総務省が「AI事業者ガイドライン(第1.2版)」を改定している。
この改定のポイントは、対象を生成AIの利用指針から「自律的に動くAIエージェント」にまで広げたことだ。具体的には、メール送信やAPI実行、発注といった影響度の高い操作に人間の承認プロセスを組み込むこと、接続可能なツールやシステムを最小権限に制限すること、判断根拠や実行結果を追跡できる履歴管理を行うことなどが実務上の統制ポイントとして示されている。
こうした履歴管理や監査証跡の整備を、人手の棚卸しに頼らずAIに任せたいという需要も出てきている。AI-SecBoxは、脆弱性の検知・修正・検証・記録までを8つの工程で自動化するオンプレミス型のシステムで、ソースコードとLLMを外部に出さない構成のまま、年次診断から日次の自動チェックへと切り替えられる。生成された監査証跡はJ-SOX・ISMS・SCSの評価にも対応しており、ガイドラインが求める統制を具体的な運用に落とし込む選択肢の一つになる。
ここまで紹介してきた事故は、いずれもこのガイドラインが求める統制のどこかが欠けていた事例として読み直すことができる。承認プロセスの形骸化、権限の絞り込み不足、検証環境と本番の未分離——これらは特別な話ではなく、「誰が・どの条件で・どこまで自動実行させるか」という、ごく基本的な設計判断の積み重ねの問題だ。
6. まとめ——自律性を上げるほど、「分離」の設計が要る
ここまで見てきた4つの事例に共通するのは、AIエージェントを「止める」仕組みの有無ではなく、そもそも与える権限の範囲と、動かす環境の境界が曖昧だったという点だ。承認を求める回数を増やすことは、むしろ形骸化した承認を増やすだけに終わりかねない。権限を絞り、検証環境と本番環境を物理的に分離しておくことの方が、結果として被害を小さくする。
この発想は、AIを"ツール"として使うのではなく、権限と役割を明確にした上で"協働"させるという考え方とも重なる。AIエージェントに仕事を任せる組織が増えるほど、どこまでの権限を渡すかという線引きは、技術的な話である以上に組織としての意思決定事項になっていく。
実務的な一歩として有効なのが、検証環境を本番から明確に分離することだ。検証環境で選ばれるマネージドコンテナサービス「Kubo」なら、月額8,800円〜という価格感で、AIエージェントの試行錯誤を本番とは切り離されたクラスタ上で安全に回すことができる。
安全なAI駆動開発の設計を体系的に学びたい方には、AI駆動開発伴走セミナーで権限設計・検証環境構築を含めた実践的な手法を学ぶという選択肢もある。自社の体制を見直したい場合は、まず無料相談で現状の課題を整理してみてほしい。